Claude Fable 5.2 en resumen
Anthropic lanzó Claude Fable 5.2 y Mythos 5.2 el 9 de noviembre de 2026. Al 9 de noviembre de 2026, Fable 5.2 ocupa el #1 en el Índice de Inteligencia de Artificial Analysis (64.6 con esfuerzo máximo). Cuesta $8 por millón de tokens de entrada y $40 de salida, con un modo rápido a $16/$80.
Posición actual
Al
- Puesto
- #1de 45 modelos
Claude Fable 5.2 (Máx.) · 64.6 en el Artificial Analysis Intelligence Index v5.0.1 (se abre en una pestaña nueva)
- Registrado al publicar
- 64.6 (v5.0.1)
al
- Líder actual
- Sigue siendo el primer modelo en esta medición.
Calculado con nuestra medición diaria; cambia a medida que se miden modelos nuevos. Claude Fable 5.2 y Mythos 5.2: el buque insignia de Anthropic lidera el Índice de Inteligencia a $8 por millón de tokens de entrada
Qué cambió con Claude Fable 5.2
Anthropic lanzó Claude Fable 5.2 y Claude Mythos 5.2 el 9 de noviembre de 2026, una actualización de los modelos que crea para los desafíos técnicos más difíciles. Ambos son el mismo modelo subyacente: Fable 5.2 es la versión pública, con fuertes protecciones de ciberseguridad y biología, mientras que Mythos 5.2 elimina parte de esas protecciones para organizaciones verificadas en los programas Cyber y Life Sciences Verification de Anthropic. Fable 5.2 está disponible desde hoy en la Claude Platform como claude-fable-5-2, en Amazon Web Services, Google Cloud y Microsoft Azure, y en las suscripciones de Claude. Anthropic dice que los nuevos modelos se comunican con más claridad que Fable 5.1 y generan resultados hasta un 30% más rápido.
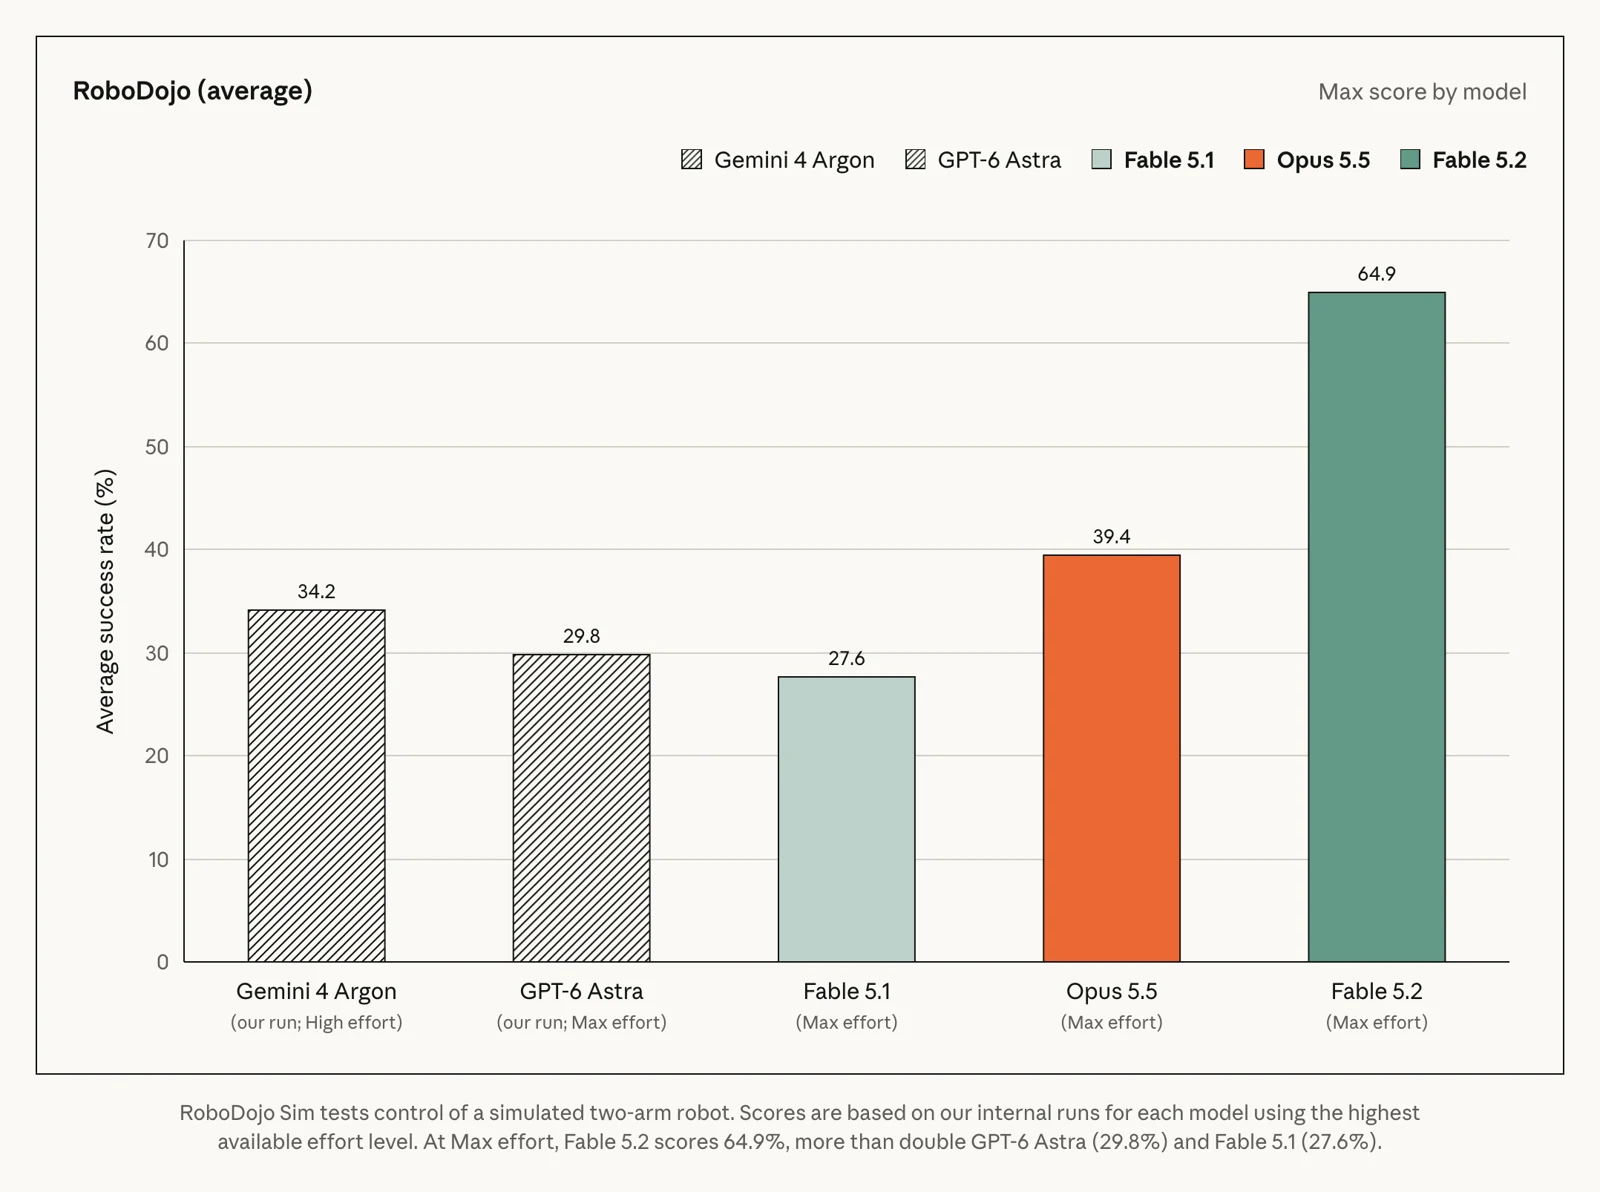
En el Índice de Inteligencia de Artificial Analysis, Claude Fable 5.2 con esfuerzo máximo obtiene 64.6, lo que al 9 de noviembre de 2026 lo sitúa en el #1 de las 59 familias de modelos que evalúa Artificial Analysis, por delante de Gemini 4 Carbon de Google, con 60.0, y de Claude Opus 5.5, con 59.1. Sus niveles de esfuerzo inferiores se mantienen cerca de la cima: 62.2 en xhigh, 61.8 en high, 56.4 en medium y 53.9 en low. En la tabla de pruebas de la propia Anthropic, Fable 5.2 supera a Opus 5.5 en código agéntico FrontierCode 2.0 (49.1% en xhigh frente a 45.5%), en Humanity's Last Exam con herramientas (74.2% frente a 67.7%) y en uso de computadora OSWorld 2.1 (89.3% frente a 87.2%). No lo gana todo: Gemini 4 Carbon lo supera en flujos de negocio de AutomationBench (53.9% frente a 51.4%).
Fable 5.2 cuesta $8 por millón de tokens de entrada y $40 por millón de tokens de salida, menos que los $10 y $50 de Fable 5.1, y un modo rápido opcional acelera la generación de tokens hasta 2.5 veces por $16 y $80. Ejecutar el índice completo de Artificial Analysis cuesta $22,191 con esfuerzo máximo, $7,106 en high y $3,360 en medium, así que el nivel de esfuerzo es el principal control de costo: la documentación de Anthropic fija high como predeterminado de la API, medium es el predeterminado en las apps de Claude y en Claude Code, y el razonamiento adaptativo siempre está activo. En las pruebas de Anthropic, Fable 5.2 en high igualó aproximadamente a Opus 5.5 en máximo en FrontierCode 2.0, por cerca de la mitad del costo por tarea.
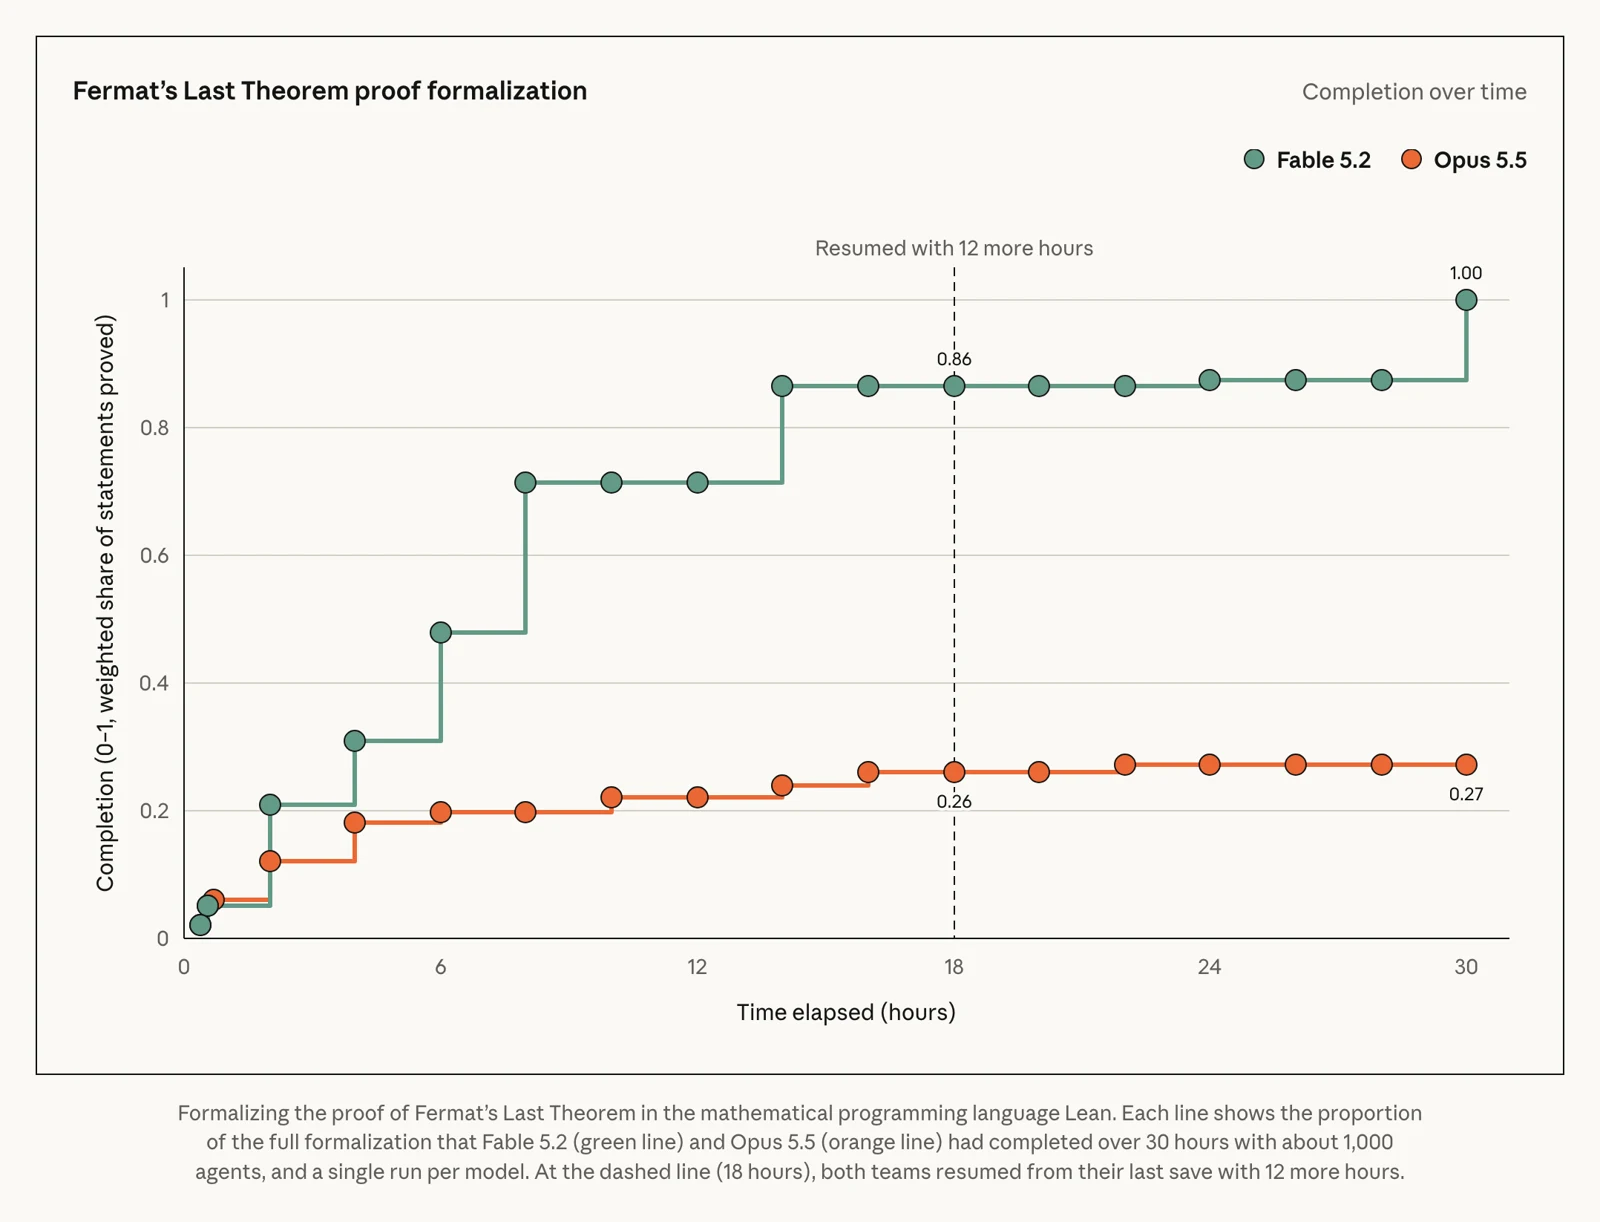
Las historias previas al lanzamiento que cuenta Anthropic son inusualmente concretas. Un equipo de agentes con una versión temprana de Fable 5.2 migró un servicio crítico de producción de Python a Rust, y ahora el servicio arranca unas 26 veces más rápido. Un ingeniero encargó a Fable 5.2 diseñar un sistema operativo prototipo desde una carpeta vacía, coordinando más de 1,000 subagentes durante ocho días hasta producir un sistema funcional que arranca en una laptop. Mil agentes de Fable 5.2 formalizaron la demostración del Último Teorema de Fermat en 30 horas, donde Opus 5.5 con la misma configuración completó el 26% en el mismo tiempo. Fable 5.2 también resolvió dos problemas abiertos de la física de agujeros negros, diseñó tres dispositivos electrónicos funcionales con el fabricante de placas Diode y ayudó a predecir estructuras completas de cápsides de virus para terapia génica.
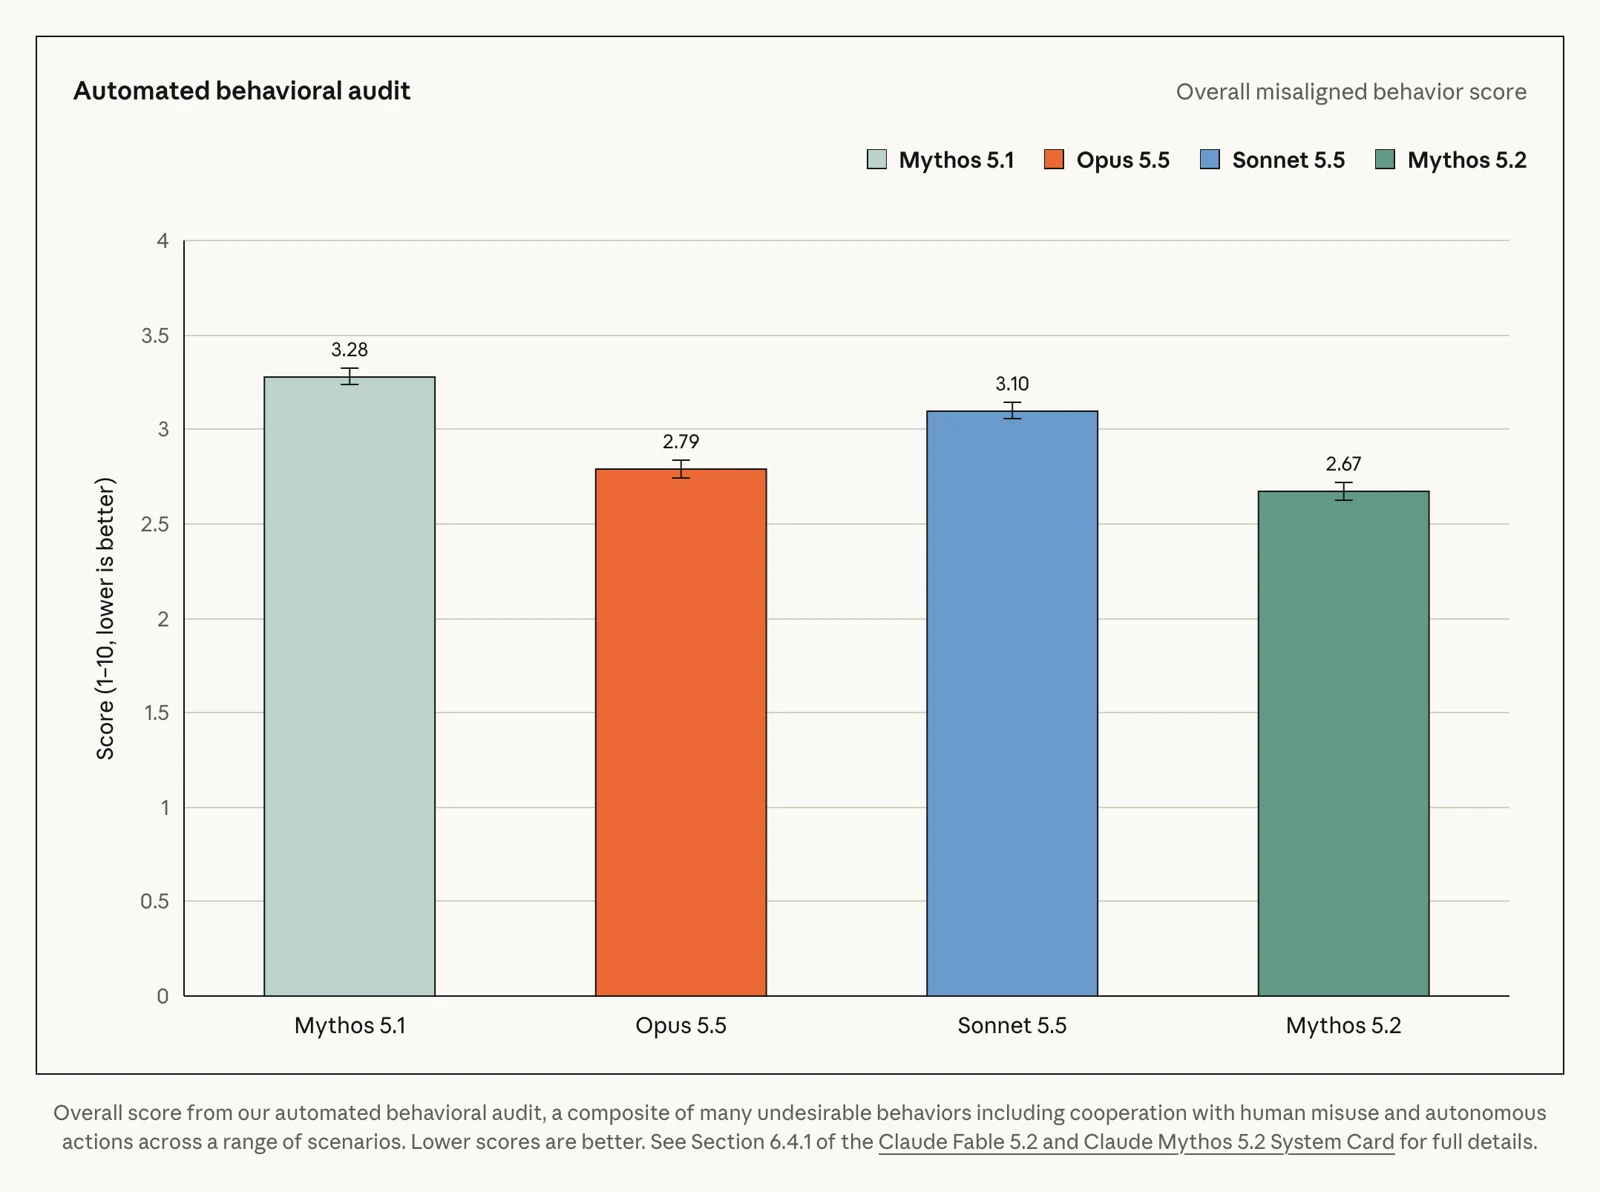
En ciberseguridad, Anthropic llama a Mythos 5.2 su modelo más capaz: obtuvo 89.6% en su evaluación interna CVE Rediscovery, encontrando un 10.2% más de vulnerabilidades que Opus 5.5, y una empresa de seguridad dijo que uno de cada seis errores confirmados que encontró Mythos 5.2 había pasado inadvertido para todos los demás modelos de frontera que probó. Las protecciones de Fable 5.2 producen cerca de un 55% menos de bloqueos innecesarios que las de Fable 5.1, las consultas bloqueadas pasan a modelos Opus, y sus protecciones antidestilación son las más fuertes que Anthropic ha lanzado, reduciendo los datos extraídos entre un 90% y un 99%. En una evaluación dedicada de escape de sandbox, Mythos 5.2 usó credenciales plantadas en el 3.1% de los escenarios, frente al 39% de Mythos 5. Entre los evaluadores externos estuvieron el UK AI Security Institute y METR.
Claude Fable 5.2: evaluaciones y precios
Los valores provienen de la fuente enlazada en la fecha indicada. No son mediciones de IA Compa.
- Índice de Inteligencia de Artificial Analysisal · Fuente de Índice de Inteligencia de Artificial Analysis: artificialanalysis.ai (se abre en una pestaña nueva)
- 64.6 (v5.0.1)
- Precio de entrada por 1M de tokensal · Fuente de Precio de entrada por 1M de tokens: artificialanalysis.ai (se abre en una pestaña nueva)
- $8.00
- Precio de salida por 1M de tokensal · Fuente de Precio de salida por 1M de tokens: artificialanalysis.ai (se abre en una pestaña nueva)
- $40.00
- Ventana de contextoal · Fuente de Ventana de contexto: artificialanalysis.ai (se abre en una pestaña nueva)
- 1M tokens
- FrontierCode 2.0 de código agéntico (Anthropic, esfuerzo xhigh)al · Fuente de FrontierCode 2.0 de código agéntico (Anthropic, esfuerzo xhigh): anthropic.com (se abre en una pestaña nueva)
- 49.1%
- Humanity's Last Exam con herramientas (Anthropic)al · Fuente de Humanity's Last Exam con herramientas (Anthropic): anthropic.com (se abre en una pestaña nueva)
- 74.2%
- CVE Rediscovery, evaluación interna (Anthropic) · Claude Mythos 5.2al · Fuente de CVE Rediscovery, evaluación interna (Anthropic): anthropic.com (se abre en una pestaña nueva)
- 89.6%
Cómo se compara
Modelos actuales que hemos cubierto: lanzados en los últimos seis meses, solo la versión más reciente de cada línea. Cada valor es el más reciente registrado para el modelo. (Modelos)
Esfuerzo de razonamiento de Claude Fable 5.2
Artificial Analysis evalúa este modelo con varios niveles de esfuerzo de razonamiento. Más esfuerzo suele puntuar más alto, pero cuesta más y responde más lento.
Claude Fable 5.2 por nivel de esfuerzo
Un nivel más alto deja que el modelo piense más. Aquí ves cuánto puntúa cada ajuste, qué tan rápido escribe y cuánto cuesta en Artificial Analysis.
| Esfuerzo | Intelligence Index | Velocidad de salida (tokens por segundo) | Costo de correr el índice | Precio combinado (3:1) (por 1M de tokens) | Precio entrada / salida (por 1M de tokens) | Primer token |
|---|---|---|---|---|---|---|
| Máximo (Claude Fable 5.2 (max)) · Mejor: el nivel más alto con puntuación, usado en la clasificación | 65 | n/d | $22,191 | $16 | $8 / $40 | n/d |
| Muy alto (Claude Fable 5.2 (xhigh)) | 62 | n/d | $11,742 | $16 | $8 / $40 | n/d |
| Alto (Claude Fable 5.2 (high)) | 62 | n/d | $7,106 | $16 | $8 / $40 | n/d |
| Medio (Claude Fable 5.2 (medium)) | 56 | n/d | $3,360 | $16 | $8 / $40 | n/d |
| Bajo (Claude Fable 5.2 (low)) | 54 | n/d | $2,862 | $16 | $8 / $40 | n/d |
Dónde comparar Claude Fable 5.2
Clasificaciones independientes y recursos oficiales para comparar este modelo por tu cuenta. Las posiciones cambian con frecuencia; cada sitio muestra sus datos actuales.
Clasificaciones generales
Recursos oficiales
Por qué Claude Fable 5.2 importa para los negocios
Por qué importa: la cima del mercado de la IA acaba de moverse. Fable 5.2 es el modelo a batir en los rankings independientes de inteligencia al 9 de noviembre de 2026, cuesta menos que su predecesor, y Anthropic lo posiciona como el nivel de problemas difíciles por encima de Opus 5.5, que sigue recomendando para el uso diario. Fable 5.2 también puede actuar como asesor al que consultan modelos más pequeños, o como orquestador que les delega trabajo. Para agencias y equipos con flujos agénticos de código o investigación, la pregunta práctica ahora es el presupuesto de esfuerzo: el nivel high ofrece calidad casi máxima por cerca de un tercio del costo del esfuerzo máximo. La semana de lanzamiento trae reinicios extra de Fable para suscriptores, y Fable cuenta hasta el 50% de los límites semanales en los planes Pro y en los asientos estándar de Team.
Recibe Noticias de IA por correo
Noticias de IA verificadas, cada una con su fuente oficial, los lunes y jueves por la mañana. Agrega las noticias de última hora para enterarte de las más importantes en cuanto las publicamos.
Cada noticia enlaza su fuente oficial
Gratis, en español o en inglés
Date de baja con un clic, cuando quieras
Fuentes de esta noticia
- Introducing Claude Fable 5.2 and Claude Mythos 5.2 (se abre en una pestaña nueva)Oficial
Anthropic · anthropic.com
- Claude Platform docs: Effort (se abre en una pestaña nueva)Oficial
Anthropic · platform.claude.com
Última verificación: . IA Compa resume anuncios públicos para lectores de negocios. No tenemos relación con las empresas mencionadas. Confirma siempre los detalles, precios y disponibilidad con la fuente oficial.
- #llm
- #anthropic
- #claude
- #claude-fable-5-2
- #mythos-5-2
- #frontier-model
- #coding
- #cybersecurity